
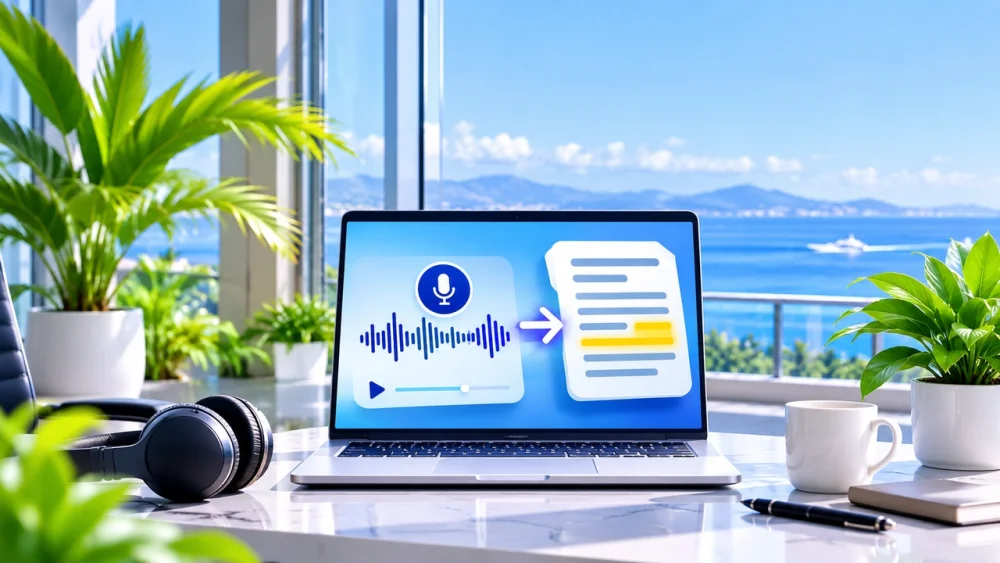
جلسهها، کلاسها، وبینارها و مصاحبهها پر از حرفهای مفید هستند، اما پیدا کردن یک جمله در فایل صوتی یکساعته وقت زیادی میگیرد. تبدیل صدای فارسی به متن با هوش مصنوعی این کار را سادهتر میکند: صدا به متنی تبدیل میشود که میشود آن را خواند، جستوجو کرد و برای صورتجلسه، مقاله یا ویدیوی کوتاه از آن استفاده کرد.
این راهنما برای مدیران، مدرسها و تولیدکنندگان محتوایی است که میخواهند از فایلهای صوتی در کار روزمره بهتر استفاده کنند. سه ابزار را معرفی میکنیم، روش کار با هرکدام را طبق راهنمای رسمی همان سرویس توضیح میدهیم و چند دستور آماده برای مرتب کردن متن میآوریم.
یک نکته را از اول در نظر داشته باشید: متنی که هوش مصنوعی تحویل میدهد پیشنویس است. نامها، عددها و اصطلاحات تخصصی ممکن است اشتباه نوشته شوند؛ پس بازبینی انسانی بخشی از کار است، نه کار اضافه.
تبدیل صدای فارسی به متن چه کمکی به کسبوکار میکند؟
وقتی حرفها به متن تبدیل شوند، دیگر لازم نیست برای پیدا کردن یک نکته کل فایل را دوباره گوش دهید. کافی است در متن جستوجو کنید. همین تغییر ساده در کارهای روزمره تیم اثر زیادی دارد.
چند کاربرد رایج:
صورتجلسه: تصمیمها، مسوول هر کار و مهلتها را سریعتر پیدا میکنید.
محتوای آموزشی: با تبدیل صدای فارسی به متن، از محتوای کلاس یا وبینار برای تهیه پیشنویس مقاله، جزوه یا پست شبکههای اجتماعی استفاده میکنید.
مصاحبه با مشتری یا متقاضی کار: موضوعات مهم را در متن پیدا میکنید و به حافظه تکیه نمیکنید.
ویدیوی کوتاه: با متن زماندار، بخشهای مناسب برای ریلز یا شورتس را راحتتر پیدا میکنید.
نتیجه هر ابزار به کیفیت صدا، لهجه گوینده و واژههای تخصصی شما بستگی دارد. برای همین بهترین راه انتخاب، امتحان کردن یک بخش کوتاه از فایل واقعی خودتان است.
قبل از شروع، فایل صوتی را آماده کنید
در تبدیل صدای فارسی به متن، کیفیت فایل روی نتیجه تاثیر مستقیم دارد. هرچه صدا واضحتر باشد، متن کمتر به اصلاح نیاز دارد. سروصدای محیط، حرف زدن همزمان چند نفر و فاصله زیاد از میکروفن رایجترین دلیل خطاها هستند.
اگر خودتان جلسه را ضبط میکنید، میکروفن را وسط میز یا نزدیک گوینده بگذارید و از افراد بخواهید وسط حرف هم نپرند. اگر نام محصول یا اصطلاح خاصی در جلسه زیاد تکرار میشود، فهرست آن را کنار دستتان نگه دارید تا هنگام بازبینی سریعتر چک کنید.
آیا باید ویدیو را به فایل صوتی تبدیل کنیم؟
همیشه لازم نیست. طبق راهنمای رسمی افزودن منبع در گوگل، فهرست فایلهای قابلقبول نوتبوکالام برای بارگذاری صوتی، علاوه بر MP3 و WAV و M4A، قالبهای MP4 و AVI را هم شامل میشود. در این حالت هم فقط گفتار فایل به متن تبدیل میشود.
اگر برای تبدیل صدای فارسی به متن از فایل ویدیویی استفاده میکنید، پذیرش آن را در سرویس انتخابی بررسی کنید. اگر ویدیو پذیرفته نمیشود یا حجمش زیاد است، صدا را جدا کنید و مثلا از MP4 یک فایل MP3 بسازید. فقط کیفیت صدا را بیش از حد پایین نیاورید، چون صدای ضعیف خطای متن را بیشتر میکند.
۱. تبدیل صدای فارسی به متن با نوتبوکالام (NotebookLM)
نوتبوکالام (NotebookLM) ابزار گوگل برای کار با منابع و یادداشتهاست. گوگل در راهنمای تازهاش آن را جمنای نوتبوک (Gemini Notebook) هم مینامد.
طبق همان راهنما، وقتی فایل صوتی را از رایانه بارگذاری میکنید، صدا همان لحظه به متن تبدیل میشود و متن آن بهعنوان یک منبع جدید ذخیره میشود. فارسی (Persian) هم در فهرست زبانهای پشتیبانیشده برای ورودی صوتی آمده است. هر منبع میتواند تا ۲۰۰ مگابایت باشد.
گامهای کار با نوتبوکالام
برای تبدیل صدای فارسی به متن در این ابزار، این گامها را طبق راهنمای رسمی گوگل انجام دهید. ظاهر صفحه ممکن است با نسخههای بعدی کمی تغییر کند.
در رایانه، نوتبوکالام را باز کنید و یک دفترچه جدید بسازید یا یکی از دفترچههای خودتان را باز کنید.
در سمت چپ، گزینه افزودن منبع (Add sources) را بزنید و فایل صوتی را انتخاب کنید.
بعد از پردازش، منبع را باز کنید تا متن تبدیلشده را ببینید.
چند بخش مهم متن را همراه صدای اصلی گوش دهید و خطاها را یادداشت کنید.
این پشتیبانی درباره ورودی صوتی است و با قابلیت ساخت پادکست خودکار (Audio Overview) که خروجی صوتی میسازد فرق دارد.
گوگل همچنین میگوید اگر کیفیت صدا پایین باشد، بارگذاری ممکن است شکست بخورد و فایل بدون گفتار پذیرفته نمیشود.
متن خام را دست نزنید؛ از آن کپی بگیرید
خروجی تبدیل صدای فارسی به متن را بهعنوان نسخه خام نگه دارید، نه سندی بیخطا. آن را مستقیم ویرایش یا با نسخه خلاصه جایگزین نکنید. متن را کپی کنید و در یک فایل جدا، مثلا با نام «متن خام جلسه»، نگه دارید.
بعد سه نسخه جدا داشته باشید:
متن خام: همان خروجی ابزار، بدون تغییر.
متن ویرایششده: همان حرفها با پاراگرافبندی و نشانهگذاری درست.
خلاصه یا صورتجلسه: برداشت شما از حرفها.
اگر بعدا درباره یک جمله شک کردید، به متن خام و صدای اصلی برمیگردید، نه به خلاصه.
دستور آماده برای پاکنویسی بدون تغییر معنا
بعد از تبدیل صدای فارسی به متن، اگر خروجی به پاراگرافبندی یا نشانهگذاری نیاز داشت، این دستور را همراه یک کپی از متن به ابزار هوش مصنوعی بدهید. فقط متنی را به این ابزارها بدهید که اجازه بارگذاری آن را دارید.
متن زیر را فقط پاراگرافبندی کن و نقطه و ویرگول بگذار. هیچ کلمهای را حذف، اضافه یا جایگزین نکن؛ حتی کلمههایی که به نظرت اشتباه یا نامفهوم هستند. نامها، عددها و تاریخها را دقیقا همانطور نگه دار. در پایان، کلمهها و جملههای مبهم را جداگانه فهرست کن تا خودم با صدای اصلی چک کنم.
بعد از گرفتن نتیجه، چند پاراگراف را با متن خام مقایسه کنید. حتی در این کار ساده ممکن است یک کلمه یا عدد عوض شود.
دستور آماده برای استخراج تصمیم، مسوول و مهلت
تبدیل صدای فارسی به متن بهتنهایی صورتجلسه آماده نمیسازد. برای تهیه صورتجلسه، از هوش مصنوعی بخواهید فقط چیزهایی را بیرون بکشد که واقعا گفته شده است:
از متن زیر فقط تصمیمهایی را فهرست کن که صریح گفته شدهاند. برای هرکدام، مسوول و مهلت را فقط اگر در متن آمده بنویس؛ اگر نیامده، بنویس «در متن مشخص نشده». چیزی را حدس نزن و کنار هر مورد جمله اصلی متن را بیاور.
آوردن جمله اصلی کمک میکند هر مورد را سریع با متن خام چک کنید.
۲. تبدیل صدای فارسی به متن با اسپیچمتیکس (Speechmatics)
اسپیچمتیکس (Speechmatics) یک سرویس تخصصی تبدیل گفتار به متن است. در فهرست زبانهای رسمی اسپیچمتیکس، فارسی (Persian) با کد fa آمده است.
طبق همان سند، دسترسی به هر زبان به قرارداد حساب کاربری بستگی دارد. پس قبل از کار با فایلهای بلند، امکان تبدیل صدای فارسی به متن را با یک فایل کوتاه در حساب خودتان امتحان کنید.
روش کار با اسپیچمتیکس
طبق صفحه شروع سریع اسپیچمتیکس، سادهترین راه امتحان این سرویس، درگاه وب (web portal) آن است. برای کارهای حجیم یا وصل کردن به نرمافزار، تیم فنی میتواند از سرویس پردازش فایل (Batch) استفاده کند.
مسیر کلی تبدیل صدای فارسی به متن در درگاه وب این است: وارد حساب شوید، فایل را بارگذاری کنید، زبان فارسی را انتخاب کنید و منتظر بمانید تا متن آماده شود. گزینهها و مدلهای در دسترس ممکن است بسته به حساب شما فرق کند.
تشخیص گویندگان در جلسه چند نفره
طبق راهنمای تشخیص گوینده اسپیچمتیکس، این سرویس میتواند متن را بر اساس صدای هر گوینده جدا کند. این قابلیت در پردازش فایل و پردازش زنده در دسترس است.
در تبدیل صدای فارسی به متن یک جلسه چند نفره، جدا کردن صدا با شناختن آدمها فرق دارد. خروجی معمولا برچسبهایی مثل «گوینده ۱» و «گوینده ۲» دارد و ابزار نمیداند گوینده ۱ همان خانم احمدی است. خودتان با گوش دادن به صدا و دانستن اینکه چه کسانی در جلسه بودند، برچسبها را با نامها تطبیق دهید. اگر صدای دو نفر شبیه باشد، ممکن است حرف یکی زیر برچسب دیگری بیاید.
پیدا کردن بخش مناسب برای ویدیوی کوتاه با فایل SRT
اگر هدف از تبدیل صدای فارسی به متن، ساخت ویدیوی کوتاه است، خروجی زماندار به کارتان میآید. فایل SRT همان زیرنویس زماندار است: کنار هر تکه متن، زمان شروع و پایان آن هم ثبت میشود. طبق راهنمای خروجی اسپیچمتیکس، در سرویس پردازش فایل (Batch) میشود خروجی متن ساده، JSON یا SRT گرفت.
برای نمونه، یک مصاحبه چهلدقیقهای دارید و میخواهید یک ویدیوی کوتاه از آن بسازید. اگر انتشار محتوای مصاحبه مجاز است، فایل SRT را با این دستور به ابزار هوش مصنوعی بدهید:
این فایل زیرنویس یک مصاحبه است. سه بخش کوتاه بین ۳۰ تا ۶۰ ثانیه پیشنهاد بده که بدون توضیح قبلی قابل فهم باشند. برای هرکدام زمان شروع و پایان را فقط از روی زمانهای همین فایل بنویس و جمله اول و آخر آن بخش را بیاور.
پیشنهاد هوش مصنوعی نقطه شروع است، نه دستور برش. قبل از تدوین، همان بخش را در ویدیوی اصلی ببینید و چک کنید جمله وسط حرف قطع نشده باشد و معنای حرف عوض نشود.
۳. تبدیل صدای فارسی به متن با ایبو (Eboo)
ایبو (Eboo) یک سرویس ایرانی برای تبدیل فایل صوتی به متن است. طبق صفحه همین سرویس، فایلهای MP3، WAV، OGG، M4A و FLAC را میپذیرد و علاوه بر فارسی، انگلیسی و عربی و چند زبان دیگر را هم پشتیبانی میکند.
مراحلی که در صفحه ایبو آمده ساده است:
روی دکمه انتخاب فایل بزنید و فایل صوتی را انتخاب کنید.
برای امتحان، گزینه تبدیل رایگان را بزنید؛ طبق صفحه سایت، یک دقیقه از فایل برای آزمایش رایگان تبدیل میشود.
برای تبدیل کامل، هزینه را از درگاه پرداخت سایت بپردازید.
قیمت هر دقیقه بعد از انتخاب فایل در خود سایت نمایش داده میشود و ممکن است تغییر کند. پیش از تبدیل صدای فارسی به متن با ایبو، تعرفه و شرایط فعلی را در همان صفحه ببینید؛ بهویژه اگر فایل بلندی دارید.
چکلیست بازبینی بعد از تبدیل صدای فارسی به متن
هیچ متن ماشینی را بدون بازبینی منبع قطعی ندانید. دستکم بخشهای حساس را با صدای اصلی تطبیق دهید. اگر متن قرار است منتشر شود یا مبنای تعهد تیم باشد، کل آن را بازبینی کنید. برای هر نقلقول یا جمله مبهم، به صدای همان بخش برگردید.
این موارد را چک کنید:
نامها: نام افراد، شرکتها، محصولات و مشتریها.
عددها و تاریخها: مبلغ، تعداد، درصد، روز و ساعت.
جملههای منفی: «انجام نمیدهیم» با «انجام میدهیم» فقط در یک حرف فرق دارد، ولی معنایش کاملا برعکس است.
مسوول و مهلت: چه کسی قرار است چه کاری را تا کی انجام دهد.
اصطلاحات تخصصی: واژههای فنی یا انگلیسی که وسط حرف فارسی آمدهاند.
برای نمونه، اگر در جلسه گفته شده «سفارش سهشنبه تحویل شود» و متن نوشته «شنبه»، برنامه تیم به هم میریزد. اگر بعد از تبدیل صدای فارسی به متن، جملهای نامفهوم بود، جای آن را علامت بزنید و همان چند ثانیه را دوباره گوش دهید. جای خالی را با حدس پر نکنید.
قبل از بارگذاری صدا، اجازه و محرمانگی را چک کنید
در تبدیل صدای فارسی به متن، فقط کیفیت فایل مهم نیست؛ محتوای فایل و مجوز بارگذاری آن را هم بررسی کنید. حتی کلاس یا یادداشت شخصی ممکن است نام مشتری یا اطلاعات حساس داشته باشد.
سه سوال ساده از خودتان بپرسید:
آیا اجازه بارگذاری این فایل در یک سرویس بیرونی را دارم؟ اینکه افراد از ضبط جلسه خبر داشتهاند، به این معنا نیست که با فرستادن صدایشان به سرویس دیگری هم موافقاند.
سیاست نگهداری داده این سرویس چیست؟ راهنمای گوگل هم توصیه میکند فایلی که حق استفادهاش را ندارید بارگذاری نکنید.
سازمان من درباره ابزارهای هوش مصنوعی قانونی دارد یا نه؟
اگر جواب یکی از اینها روشن نیست، با فایلی شروع کنید که اطلاعات حساس ندارد و اجازه بارگذاری آن را دارید. یادتان باشد وقتی متن را برای خلاصهنویسی به ابزار دیگری میدهید، قوانین آن ابزار هم جداگانه اعمال میشود.
تمرین ساده: یک فایل، سه ابزار
برای اینکه ببینید کدام روش تبدیل صدای فارسی به متن با صدای شما بهتر کار میکند، یک فایل صوتی پنج تا ده دقیقهای انتخاب کنید که اطلاعات محرمانه ندارد؛ مثلا یک بخش از کلاس یا یادداشت صوتی خودتان. سعی کنید در فایل چند نام، چند عدد و یکی دو اصطلاح تخصصی باشد تا مقایسه واقعیتر شود.
مراحل تمرین:
همین فایل را در نوتبوکالام بارگذاری کنید و متن خام را جدا ذخیره کنید.
اگر به اسپیچمتیکس یا ایبو دسترسی دارید، همان فایل را در آنها هم امتحان کنید.
دو دقیقه از فایل را همراه هر متن گوش دهید و خطاهای نام، عدد و جملههای منفی را بشمارید.
دستور پاکنویسی را روی بهترین متن اجرا کنید و نتیجه را با متن خام مقایسه کنید.
برای مقایسه ابزارهای تبدیل صدای فارسی به متن، نتیجه را از قبل حدس نزنید. ببینید اصلاح متن هرکدام چقدر وقت میگیرد و خروجی آن به کارتان میآید یا نه. ابزاری که برای لهجه، کیفیت صدا و واژههای کاری شما بهتر جواب داد، گزینه مناسبتری است.
جمعبندی
تبدیل صدای فارسی به متن با هوش مصنوعی زمان پیادهسازی جلسهها، کلاسها و مصاحبهها را کم میکند و استفاده دوباره از آنها را آسانتر میکند. نوتبوکالام، اسپیچمتیکس و ایبو هرکدام طبق مستندات خودشان امکانات متفاوتی دارند؛ انتخاب درست با امتحان روی فایل خودتان مشخص میشود.
متن خام را نگه دارید، ویرایش و خلاصه را جدا بسازید و نام، عدد، تاریخ و جملههای منفی را با صدای اصلی چک کنید. اگر میخواهید از متن جلسهها و کلاسها محتوای آموزشی بسازید، مقاله ساخت دوره آموزشی از ویدیوهای یوتیوب با NotebookLM هم برایتان مفید است.
برای یادگیری عمیقتر کاربردهای هوش مصنوعی در کسبوکار، دوره هوش مصنوعی بیزنس پلاس را ببینید.