
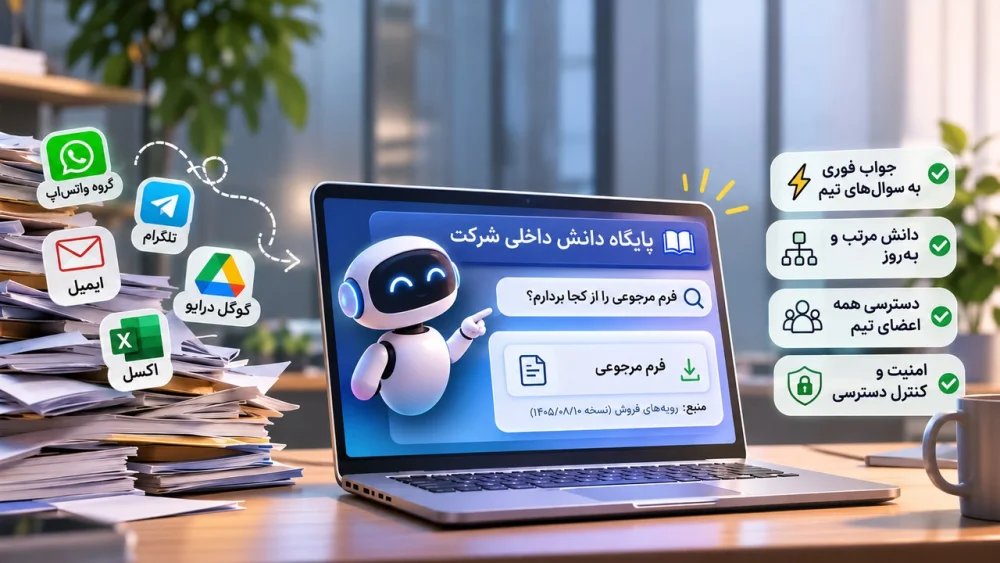
اگر هر روز یکی از همکارها میپرسد «لیست قیمت جدید کجاست؟» یا «فرم مرجوعی را از کجا بردارم؟»، کسبوکارت به یک پایگاه دانش داخلی نیاز دارد: یک جای مرتب که جواب همه این سوالها در آن هست و حالا با کمک هوش مصنوعی میشود در چند ثانیه از آن سوال پرسید و جواب گرفت.
در بیشتر شرکتهای کوچک و متوسط، دانش کار در پنج شش جا پخش است: گروه واتساپ (WhatsApp) و تلگرام (Telegram)، پوشههای گوگل درایو (Google Drive)، ایمیل، فایلهای اکسل (Excel) روی لپتاپ حسابدار و ذهن دو سه نفر قدیمی تیم. کافی است یکی از همین آدمها مرخصی برود تا نصف کارها بخوابد.
در این مقاله قدمبهقدم میبینی چطور یک پایگاه دانش داخلی بسازی: فایلهای پراکنده را جمع کنی، مرتب کنی و به یک دستیار هوشمند بسپاری که از روی همان فایلها جواب بدهد. ابزارهای اصلی را هم با امکانات واقعی امروزشان معرفی میکنیم و نکتههای امنیتی را میگوییم تا اطلاعات حساس شرکت جای اشتباهی نرود.
پایگاه دانش داخلی چیست؟
پایگاه دانش داخلی مجموعهای از سندها، دستورالعملها، جواب سوالهای پرتکرار و تصمیمهای مهم شرکت است که برای خود تیم نوشته شده، نه برای مشتری. مثلا روند ثبت سفارش، قانون مرجوعی، لیست قیمت، قرارداد نمونه، راهنمای نرمافزار حسابداری و جواب سوالهایی که هر هفته تکرار میشوند.
فرقش با یک پوشه شلوغ در سه چیز است: هر صفحه یک موضوع روشن دارد، یک نفر مسوول بهروز نگه داشتنش است و همه میدانند نسخه درست کدام است. پوشهای که در آن «قرارداد نهایی»، «قرارداد نهایی ۲» و «قرارداد این یکی درسته» کنار هم نشستهاند، پایگاه دانش داخلی نیست؛ انبار فایل است.
هوش مصنوعی این وسط نقش یک کتابدار باهوش را دارد. کارمند به جای گشتن بین ده فایل، سوالش را خیلی عادی مینویسد و دستیار از روی همان سندها جواب کوتاه میدهد و میگوید جواب را از کدام فایل آورده است. شرط اصلی این است که خود سندها مرتب و درست باشند.
فایلهای پراکنده چقدر وقت تیم را هدر میدهند؟
شرکت اتلسین (Atlassian) در گزارش وضعیت تیمها در سال ۲۰۲۵ از ۱۲ هزار کارمند دانشی و ۲۰۰ مدیر ارشد نظر گرفت. نتیجه این بود که مدیران و تیمها حدود یکچهارم وقت هفته کاری را فقط صرف پیدا کردن اطلاعات میکنند و ۵۶ درصد کارمندها گفتهاند اغلب تنها راه گرفتن اطلاعات، پرسیدن از یک نفر یا گذاشتن جلسه است.
داده تازهتر هم همین را میگوید. در نظرسنجی سال ۲۰۲۶ استک اورفلو (Stack Overflow) که بیش از ۱۲ هزار برنامهنویس و فعال فنی به آن جواب دادهاند، ۷۵ درصد گفتهاند هر هفته ۵ ساعت یا بیشتر فقط دنبال اطلاعات لازم برای کارشان میگردند و ۱۱ درصد حتی ۲۰ ساعت یا بیشتر.
نکته مهمتر در گزارش وضعیت تیمها در سال ۲۰۲۶ آمده است: ۸۵ درصد کارمندها از هوش مصنوعی در کار استفاده میکنند، ولی فقط ۲۹ درصد آن را واقعا وارد روند کار روزانه کردهاند. در متن کامل همین گزارش آمده که فقط ۲۲ درصد کارمندها به دقت هوش مصنوعی کاملا اعتماد دارند؛ گزارش از «بدهی داده»، یعنی دادههای نامرتب و قدیمی، به عنوان یکی از ترمزهای اصلی نام میبرد.
پس مشکل اول نبودن هوش مصنوعی نیست، نامرتب بودن دانش است. اگر فایلها بههمریخته باشند، هوش مصنوعی هم جواب بههمریخته میدهد. برای همین ساختن پایگاه دانش داخلی قبل از هر چیز یک کار مدیریتی است و بعد یک کار فنی.
ساخت پایگاه دانش داخلی با هوش مصنوعی در ۷ گام
خیلی از مدیرها کار را از خرید ابزار شروع میکنند و بعد از یک ماه میبینند کسی سراغش نمیرود. ترتیب درست برعکس است: اول معلوم کن تیم چه سوالهایی دارد، بعد جوابها را مرتب کن و آخر سر هوش مصنوعی را روی آن سوار کن. این همان منطقی است که در سیستم سازی با هوش مصنوعی هم گفتیم: اول فرایند، بعد ابزار.
لازم نیست همه دانش شرکت را یکجا جمع کنی. با یک واحد شروع کن، مثلا فروش یا پشتیبانی، و نسخه اول را در دو سه هفته بالا بیاور. وقتی تیم دید جواب سوالش را در چند ثانیه میگیرد، خودش برای اضافه کردن بقیه بخشها داوطلب میشود.
۱. اول سوالهای پرتکرار را جمع کن، نه فایلها را
یک هفته از تیم بخواه هر سوالی که از همکار یا مدیر میپرسند را در یک فایل ساده بنویسند. همینطور پیامهای گروه کاری یک ماه اخیر را مرور کن و سوالهای تکراری را بیرون بکش. معمولا بعد از یک هفته به ۳۰ تا ۵۰ سوال میرسی که بیشتر وقت تیم را میگیرند.
این فهرست، نقشه پایگاه دانش داخلی است. هر سوالی که پنج بار تکرار شده، باید یک صفحه جواب روشن داشته باشد. سوالها را بر اساس تعداد تکرار مرتب کن و کار را از بالای فهرست شروع کن تا زودتر نتیجه ببینی. لازم نیست همه سوالها از روز اول جواب داشته باشند.
۲. فایلهای مهم را از همه جا یکجا کن
حالا برای هر سوال، سندی که جوابش را دارد پیدا کن: فایلهای درایو، پیامهای سنجاقشده گروهها، ایمیلهای مهم، صورتجلسهها و فایلهای روی سیستم افراد. همه را در یک پوشه موقت به اسم «مواد خام» بریز تا بعدا مرتبشان کنی و فقط بهترینها وارد پایگاه دانش داخلی شوند.
بخش مهمی از دانش هیچجا نوشته نشده و فقط در ذهن آدمهاست. برای اینها از فرد باتجربه بخواه جواب را با صدا ضبط کند یا ده دقیقه برایت توضیح بدهد. متن پیادهشده صدا را با هوش مصنوعی به یک صفحه مرتب تبدیل کن و برای تایید به همان فرد برگردان.
۳. پاکسازی: نسخه قدیمی، تکراری و متناقض را کنار بگذار
این مهمترین و وقتگیرترین گام است. از هر سند فقط آخرین نسخه درست را نگه دار. لیست قیمت پارسال، قرارداد منسوخ و دستورالعملی که دیگر کسی اجرایش نمیکند را در پوشه «بایگانی»، بیرون از پایگاه دانش داخلی، بگذار تا هوش مصنوعی آنها را نخواند.
اگر دو سند حرف متفاوت میزنند، مثلا یکی میگوید مهلت مرجوعی ۷ روز است و دیگری ۱۰ روز، تکلیف را با مدیر همان بخش روشن کن. هوش مصنوعی نمیداند کدام درست است و ممکن است هر بار یکی را بگوید. یک ساعت پاکسازی اینجا، جلوی صدها جواب غلط را میگیرد.
۴. یک قالب ساده برای هر صفحه بچین
هر صفحه پایگاه دانش داخلی بهتر است یک قالب ثابت داشته باشد: عنوان به شکل سوال، جواب کوتاه در دو سه خط، توضیح گامبهگام، نام مسوول صفحه و تاریخ آخرین بازبینی. این قالب هم خواندن را برای آدم راحت میکند و هم کار هوش مصنوعی را دقیقتر.
صفحههای پایگاه دانش داخلی را در چند دسته محدود بچین، مثل فروش، پشتیبانی، مالی، منابع انسانی و محصول. برای نوشتن صفحههای گامبهگام، قالب دستورالعمل یکصفحهای نقطه شروع خوبی است. یادت باشد هر صفحه فقط یک موضوع داشته باشد؛ صفحههای چندموضوعی جوابها را قاطی میکنند.
۵. هوش مصنوعی را وصل کن و با سوال واقعی تست کن
حالا سندهای تمیز پایگاه دانش داخلی را به ابزار انتخابی بده و یک دستورالعمل کوتاه برای دستیار بنویس. مثلا: «فقط از روی سندهای همین پوشه جواب بده، منبع هر جواب را بگو و اگر جواب در سندها نبود، صادقانه بگو نمیدانم و فرد مسوول را معرفی کن.» برای نوشتن این دستور، راهنمای نوشتن پرامپت هوش مصنوعی کمکت میکند.
بعد همان فهرست سوالهای گام اول را یکییکی از دستیار بپرس و جوابها را با جواب درست مقایسه کن. هر جا جواب اشتباه یا ناقص بود، معمولا ایراد از سند است، نه از ابزار. سند را اصلاح کن و دوباره بپرس تا بیشتر سوالهای مهم درست جواب داده شوند.
۶. دسترسیها را قبل از باز کردن در به روی همه تعیین کن
همه اطلاعات برای همه نیست. حقوق کارکنان، حاشیه سود، اطلاعات شخصی مشتریها و قراردادهای محرمانه نباید در دسترس کل تیم باشد. قبل از اینکه دستیار را به همه بدهی، مشخص کن هر گروه چه بخشهایی از پایگاه دانش داخلی را ببیند.
بیشتر ابزارهای جدی فقط چیزی را نشان میدهند که کاربر اجازه دیدنش را دارد، ولی این قانون فقط وقتی کار میکند که مجوز پوشهها درست تنظیم شده باشد. اگر پوشه حقوق را برای همه باز گذاشته باشی، هوش مصنوعی هم با کمال میل جوابش را به همه میدهد.
۷. بهروز نگه داشتن را جزو کار هفتگی کن
پایگاه دانش داخلی که بهروز نشود، بعد از چند ماه از هیچ بدتر است، چون با اطمینان جواب قدیمی میدهد. برای هر دسته یک مسوول بگذار و قانون سادهای تعیین کن: هر تغییر در قیمت، روند یا قانون، همان روز در صفحه مربوطش ثبت شود.
ماهی یک بار هم نیم ساعت وقت بگذار و صفحههایی را که تاریخ بازبینیشان قدیمی شده مرور کن. یک راه خوب این است که از تیم بخواهی هر سوالی که دستیار جوابش را نداشت گزارش کنند. همین گزارشها نشان میدهد کدام صفحه از پایگاه دانش داخلی جا افتاده است.
۵ ابزار مناسب برای پایگاه دانش داخلی با هوش مصنوعی
ابزار درست برای پایگاه دانش داخلی به این بستگی دارد که فایلهایت الان کجاست و تیمت چقدر بزرگ است. اگر همه چیز در گوگل درایو است، ابزارهای گوگل راحتترند؛ اگر شرکت روی مایکروسافت (Microsoft) کار میکند، کوپایلت (Copilot) طبیعیتر است. برای تیمهای خیلی کوچک هم گاهی یک پروژه ساده در چت جی پی تی (ChatGPT) کافی است.
امکانات و محدودیتهایی که در ادامه میآید از صفحههای رسمی خود این ابزارها در سال ۲۰۲۶ برداشته شده است. قبل از خرید، صفحه قیمت هر ابزار را دوباره ببین، چون این شرکتها امکاناتشان را مدام تغییر میدهند.
۱. نوشن (Notion)
نوشن (Notion) هم جای نوشتن و مرتب کردن صفحههاست و هم هوش مصنوعی داخلی دارد. دستیار آن از روی صفحهها و پایگاههای داده فضای کاری جواب میدهد و در پلن بیزینس، جستجوی سازمانی هم دارد که در اسلک (Slack)، گوگل درایو و گیتهاب (GitHub) هم دنبال جواب میگردد.
یک امکان خیلی مفید آن نشان «تاییدشده» برای صفحههای بهروز است که در نتیجه جستجو و منبع جوابهای هوش مصنوعی هم دیده میشود. فضای تیمی خصوصی هم دارد که برای اطلاعات حساس مثل ارزیابی عملکرد مناسب است. نوشن میگوید داده مشتری، مگر با اجازه خود کاربر، برای آموزش مدلها استفاده نمیشود.
۲. جمنای نوتبوک (Gemini Notebook)
جمنای نوتبوک (Gemini Notebook) همان ابزاری است که قبلا اسمش نوتبوک الام (NotebookLM) بود. فایلهای پیدیاف، گوگل داک (Google Docs)، اسلاید، لینک سایت، ویدیوی یوتیوب (YouTube) و فایل صوتی را به آن میدهی و فقط از روی همین منابع جواب میگیری. هر جواب ارجاع دارد و با یک کلیک به همان جمله در سند اصلی میرسی.
طبق صفحه پلنهای گوگل، نسخه رایگان تا ۵۰ منبع در هر دفترچه و نسخه پرو تا ۳۰۰ منبع میپذیرد و هر منبع میتواند تا ۵۰۰ هزار کلمه باشد. فقط یادت باشد از هر فایل یک نسخه ثابت نگه میدارد و بعد از تغییر سند باید آن را دوباره همگام کنی. اگر میخواهی بیشتر بدانی، مقاله جمنای نوتبوک چیست را بخوان.
۳. چت جی پی تی (ChatGPT): پروژهها و دانش شرکت
در چت جی پی تی با بخش پروژهها میتوانی فایلها، دستورالعمل و گفتگوها را یکجا نگه داری و پروژه را با همکارها به اشتراک بگذاری. پلن پلاس تا ۲۵ فایل و پلنهای بیزینس و پرو تا ۴۰ فایل در هر پروژه میپذیرند و لینک پوشه گوگل درایو یا کانال اسلک را هم میشود منبع پروژه کرد.
برای شرکتهای بزرگتر، امکان «دانش شرکت» در پلنهای بیزینس و انترپرایز به ابزارهایی مثل اسلک، شیرپوینت (SharePoint)، گوگل درایو و هاباسپات (HubSpot) وصل میشود، جواب را با لینک منبع میدهد و به مجوز هر کاربر احترام میگذارد. اوپن ایآی (OpenAI) میگوید داده پلنهای سازمانی را به طور پیشفرض برای آموزش مدل استفاده نمیکند.
۴. مایکروسافت ۳۶۵ کوپایلت (Microsoft 365 Copilot)
اگر ایمیل، فایل و جلسههای شرکت روی مایکروسافت ۳۶۵ است، مایکروسافت ۳۶۵ کوپایلت (Microsoft 365 Copilot) انتخاب طبیعی است. طبق سند رسمی حریم خصوصی مایکروسافت، کوپایلت از ایمیلها، گفتگوها و سندهایی جواب میدهد که کاربر حداقل اجازه دیدنشان را دارد.
مایکروسافت در همان سند تاکید میکند که درخواستها و جوابها برای آموزش مدلهای پایه استفاده نمیشوند. البته خودش هم میگوید جوابهای هوش مصنوعی صددرصد درست نیستند و باید قبل از استفاده بازبینی شوند. پس اینجا هم تنظیم درست مجوزهای شیرپوینت و پاکسازی سندهای پایگاه دانش داخلی شرط اول است.
۵. گورو (Guru)
گورو (Guru) از اول برای همین کار ساخته شده: دانش پراکنده را مرتب میکند و جواب را با منبع تحویل میدهد. نسخههای متناقض و تکراری را پیدا میکند، صفحههای قدیمی را علامت میزند و برای بازبینی به آدم متخصص همان موضوع میفرستد.
گورو جوابها را بر اساس نقش و مجوز هر نفر نشان میدهد و داخل اسلک و تیمز (Microsoft Teams) هم کار میکند. برای تیمهایی که بیشترین دغدغهشان قدیمی شدن اطلاعات است، این نظارت خودکار ارزش زیادی دارد، ولی برای یک تیم پنجنفره ممکن است بیشتر از نیاز باشد.
امنیت و حریم خصوصی: قبل از آپلود اینها را چک کن
پایگاه دانش داخلی یعنی جمع کردن مهمترین اطلاعات شرکت در یک جا؛ پس اگر بیدقت ساخته شود، یک جا هم لو میرود. قبل از آپلود هر فایل، شرایط استفاده و حریم خصوصی ابزار را بخوان و ببین دادهات برای آموزش مدل استفاده میشود یا نه و چه مدت نگه داشته میشود.
حسابهای رایگان و شخصی معمولا قانونهای سختگیرانه پلنهای سازمانی را ندارند. اگر قرار است اطلاعات واقعی شرکت را وارد پایگاه دانش داخلی کنی، از حساب سازمانی استفاده کن. این چند قانون ساده هم جلوی بیشتر دردسرها را میگیرد و بهتر است از روز اول جدی گرفته شود:
شماره کارت، رمز عبور، اطلاعات شخصی مشتری و حقوق افراد را وارد بخش عمومی پایگاه دانش داخلی نکن.
برای اطلاعات حساس یک فضای جدا با دسترسی محدود بساز.
وقتی کسی از شرکت میرود، همان روز دسترسیاش را ببند.
به دستیار یاد بده در موضوعات مالی و حقوقی جواب نهایی ندهد و کاربر را به فرد مسوول ارجاع بدهد.
ماهی یک بار فهرست افرادی که به هر بخش دسترسی دارند را مرور کن.
اگر برای اولین بار است که هوش مصنوعی را وارد شرکت میکنی، خواندن اشتباهات پیاده سازی هوش مصنوعی کمک میکند خطاهای گران رایج را تکرار نکنی. بیشتر این خطاها از عجله و نداشتن نقشه شروع میشوند، نه از ضعف ابزار.
مثال ساده: پایگاه دانش یک فروشگاه اینترنتی کوچک
فرض کن یک فروشگاه اینترنتی لوازم آشپزخانه با ۱۲ نفر نیرو داری. هر روز کارشناسهای پشتیبانی سوالهای تکراری مشتری را از مدیر فروش میپرسند: هزینه ارسال به شهرستان، شرایط گارانتی، مهلت مرجوعی و موجودی انبار. مدیر فروش هم نصف روزش را به جواب دادن میگذراند، چون شرکت هنوز پایگاه دانش داخلی ندارد.
مدیر یک هفته سوالها را جمع میکند و به ۴۰ سوال میرسد. برای هر کدام یک صفحه کوتاه در گوگل داک مینویسد، نسخههای قدیمی لیست قیمت را بایگانی میکند و همه را در یک دفترچه جمنای نوتبوک میگذارد. بعد ده دقیقه به تیم یاد میدهد سوالشان را اول از دستیار بپرسند و منبع جواب را چک کنند.
حالا وقتی مشتری درباره گارانتی همزن برقی سوال میکند، کارشناس در چند ثانیه جواب را با منبعش پیدا میکند. مدیر فروش هم فقط سوالهایی را جواب میدهد که در پایگاه دانش داخلی نیست و همانها را به صفحههای جدید تبدیل میکند. این پایگاه دانش داخلی هر ماه کاملتر از ماه قبل میشود.
اشتباهات رایج در ساخت پایگاه دانش
بیشتر پروژههای پایگاه دانش داخلی نه به خاطر ابزار، بلکه به خاطر چند اشتباه ساده شکست میخورند. اگر این اشتباهها را از قبل بشناسی، خیلی راحت میتوانی جلویشان را بگیری. رایجترینشان اینهاست:
ریختن همه فایلها بدون پاکسازی و انتظار جواب درست از هوش مصنوعی.
نداشتن مسوول برای هر بخش؛ صفحهای که صاحب ندارد، زود کهنه میشود.
شروع با کل شرکت به جای یک واحد و خسته شدن در هفته دوم.
اعتماد کامل به جوابها بدون چک کردن منبع، بهخصوص در عددها و قیمتها.
آموزش ندادن به تیم؛ اگر کسی عادت نکند اول از دستیار بپرسد، باز سراغ همکارش میرود.
راه پیشگیری از همه اینها در واقع یکی است: پایگاه دانش داخلی را یک سیستم زنده ببین، نه یک پروژه یکباره. همانطور که حسابوکتاب را هر ماه مرور میکنی، دانش شرکت را هم باید مرتب مرور و اصلاح کنی تا همیشه قابل اعتماد بماند.
جمعبندی
پایگاه دانش داخلی با هوش مصنوعی یعنی تیم به جای پرسیدن از همکار و گشتن بین گروهها، سوالش را بنویسد و در چند ثانیه جواب درست با منبع بگیرد. راهش هم پیچیده نیست: سوالها را جمع کن، سندها را پاک کن، قالب بچین، ابزار مناسب را وصل کن، دسترسیها را ببند و بهروز نگهش دار.
همین هفته فقط گام اول را انجام بده: از تیم بخواه سوالهایشان را یک هفته بنویسند. همین فهرست نشان میدهد پایگاه دانش داخلی شرکتت از کجا باید شروع شود و هر ساعت وقتی که برایش بگذاری، چند ساعت از وقت تیم را آزاد میکند.